ビジネスの売上分析から学校の試験結果まで、数多くの数値データを要約する際に避けて通れないのが「代表値」の扱いです。なかでも「平均値を算出したものの、一部の極端な数値に引っ張られて現場の肌感覚とまったく合わなかった」という苦い経験を持つビジネスパーソンや学生は少なくありません。そうした数値の歪みを排し、「最も頻繁に発生しているリアルな状況」を浮き彫りにする指標こそが最頻値(モード)です。
しかし、いざ実務や学習の現場で扱おうとすると、「度数分布表にまとまっている場合はどこを指すのか」「最も多い数値が2つ以上存在するときはどう書くべきか」「Excelではどの関数を選べばよいのか」といった実践的な疑問に直面します。本記事では、統計学の基本原則から中学数学の解法ルール、さらには実務直結のExcelテクニックまで、最頻値の求め方に関するすべての手順を分かりやすく体系化して解説します。
【基本手順】最頻値(モード)の求め方と知っておくべき計算の基礎
統計学における最頻値mode(モード)とは、対象となるデータ群の中で「最も多く現れる値」を指します。英語の「fashion(流行)」と同根の語源を持ち、文字通りその集団内で最もポピュラーな数値を表す指標です。
文部科学省の中学校学習指導要領でも、中学数学データの活用単元において中央値や平均値と並ぶ重要概念として位置づけられています。生データ(整理されていないそのままの数値の列)から割り出す最頻値の計算手順まとめは、以下の3ステップで完了します。
例えば、あるチームのメンバー9人が1週間に読んだ本の冊数が「2, 1, 3, 2, 5, 2, 4, 1, 3」だったとします。
まずデータを昇順に並べ替えると、「1, 1, 2, 2, 2, 3, 3, 4, 5」となります。
それぞれの出現回数(度数)を数えると、1冊が2人、2冊が3人、3冊が2人、4冊が1人、5冊が1人です。
したがって、最も度数が多い数値である「2冊」がこのデータの最頻値となります。
複雑な計算式を解く必要がなく、データを整理してカウントするだけで直感的に把握できる点が、最頻値ならではの大きな利点です。加えて、最頻値は数値データ(量的データ)だけでなく、「好きな色」「売れ筋の洋服のサイズ(S/M/L)」といったカテゴリデータ(質的データ)に対しても適用できる唯一の代表値という際立った特徴を持っています。
【徹底比較】最頻値と中央値と平均値の違い|代表値の使い分けと理由
データ分析の現場で最も頻発するミスが、「とりあえず平均値を出しておけば安心」という思い込みです。厚生労働省が公表する「国民生活基礎調査」の所得データを見ても明らかなように、一部の超富裕層が数値を大きく引き上げるため、平均所得(約540万円台)は実態よりもかなり高く算出されます。これに対し、所得が低い順に並べた中央値は約400万円台前半、最も世帯数が多い階級である最頻値は200万〜300万円台に位置します。
このように、数値が左右非対称に偏っている場合、平均値だけを見ていると大衆の生活実態を完全に見誤ってしまいます。そこで不可欠となるのが、代表値の使い分けと理由を正しく把握することです。
| 指標名 | 定義と算出のアプローチ | 得意なデータ・メリット | デメリット・盲点 |
|---|---|---|---|
| 最頻値(Mode) | 最も出現頻度が高い値 | 外れ値の影響を一切受けない。洋服サイズやアンケート集計など質的データにも有効 | データの総量が反映されない。データ数が少ないと偶然の偏りに左右されやすい |
| 中央値(Median) | データを順に並べた真ん中の値 | 外れ値に極めて強い。貯蓄額、年収、不動産価格など偏りの大きいデータの把握に最適 | 中央以外の全データがどのような数値分布をしているかが削ぎ落とされる |
| 平均値(Mean) | 全データの合計 ÷ データ総数 | 全データの数値を漏れなく反映。テストの総得点や売上予測など数学的処理に優れる | 極端な外れ値(異常値)が1つあるだけで、数値全体が大きく吊り上がってしまう |
最頻値と中央値と平均値の違いを一言でまとめるなら、「どこに焦点を当てているか」の視点の違いです。全体の総和を均等配分した理論値を知りたいなら「平均値」、順位としてちょうど真ん中のポジションを知りたいなら「中央値」、そして「現場で最も普通に起こる典型例」を知りたいなら「最頻値」を選択するのが統計分析の鉄則です。
【実践編】度数分布表とヒストグラムの最頻値の求め方|度数分布表の階級値とは
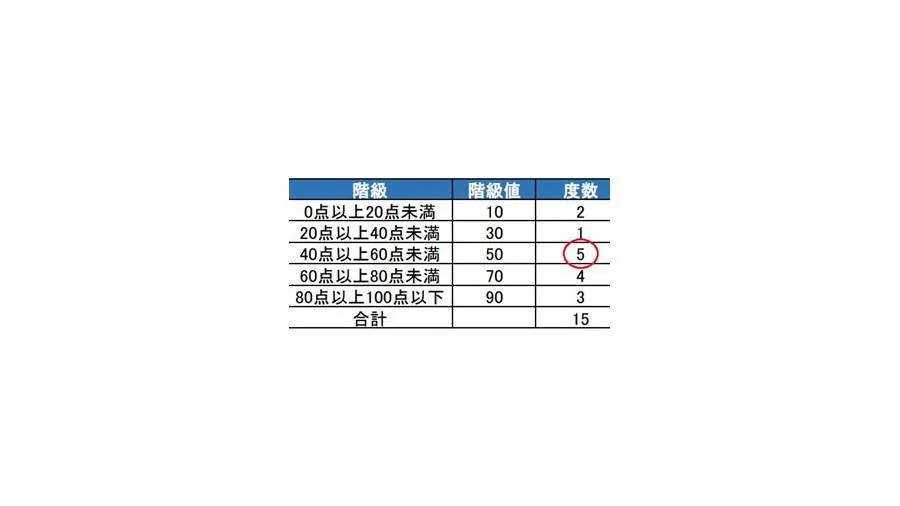
学校の数学テストや公的統計のレポートでは、生データではなくデータを一定の区間に区切った「度数分布表」や「ヒストグラム」の形式で提示されることが一般的です。ここで多くの人が「区間(例:50点以上60点未満)になっている場合、どうやって1つの数値を答えるのか」と戸惑います。
結論から言えば、度数分布表の最頻値の求め方には明確な数学的ルールが存在します。「度数が最も大きい階級を見つけ、その階級の度数分布表の階級値(中央の値)を最頻値とする」という手順を踏みます。
具体例として、30人クラスの数学テスト結果が以下の度数分布表にまとめられているケースを考えます。
- 40点以上 〜 50点未満:3人
- 50点以上 〜 60点未満:7人
- 60点以上 〜 70点未満:12人(度数最大)
- 70点以上 〜 80点未満:6人
- 80点以上 〜 90点未満:2人
この場合、最も人数が多い(度数が最大な)階級は「60点以上 〜 70点未満」の12人です。
最頻値を答える際は、この階級の範囲をそのまま書くのではなく、階級の真ん中の値である階級値を計算します。
階級値の計算式:
(階級の下限値 + 階級の上限値)÷ 2 = (60 + 70)÷ 2 = 65点
したがって、この度数分布表における最頻値は「65点」となります。「60点〜70点」と答えるとテストでは減点対象となるため注意してください。
グラフ化されたヒストグラムの最頻値を求める場合も原理は全く同一です。ヒストグラムの中で「最も柱(バー)が高い階級」を探し、その柱の横軸の中央の値を読み取ります。視覚的に山の頂上を見つける作業となるため、視覚的な直感と計算結果が綺麗に一致します。
【疑問を解消】最頻値が複数ある場合の対処法と存在しない場合のルール
検索クエリや知恵袋等の質問サイトで極めて多く見られるのが、「最大出現回数の数値が2つ以上並んだらどうするのか」「全部の数値がバラバラなときはどう答えるのか」という疑問です。ここには明確な対処ルールが存在します。
1. 最頻値が2つ以上ある場合(二峰性・多峰性)
最頻値が複数ある場合の対処法はシンプルで、「該当する数値をすべて書き出す」のが正解です。平均値のように足して2で割るような加工は絶対にしてはいけません。
例えば「1, 2, 2, 2, 4, 5, 5, 5, 6」というデータがある場合:
・「2」が3回出現
・「5」が3回出現
どちらも最大出現回数であるため、最頻値の答えは「2 と 5」(または「2, 5」)となります。
統計学において、最頻値が2つある分布を「二峰性(バイモーダル)分布」、3つ以上ある場合を「多峰性(マルチモーダル)分布」と呼びます。例えば飲食店のランチタイム(12時台)とディナータイム(19時台)の客足のように、背景に異なる2つの要因が混ざり合っていることを示唆する極めて有益なシグナルとなります。
2. 最頻値が存在しない場合(度数がすべて均一)
一方で、最頻値が存在しない場合のルールも定義されています。すべてのデータの出現回数がまったく同じである場合、最頻値は「なし」と答えるのが数学的な決まりです。
例えば「3, 5, 8, 12, 15」のように全データが1回ずつしか現れない場合や、「2, 2, 4, 4, 7, 7」のようにすべての値が同数(2回ずつ)出現している場合は、特定の値が「最も頻繁」とは言えません。したがって、この場合の解答は「最頻値なし」となります。「0」と答えてしまうと「数値の0が最も多い」という意味になってしまうため、大きな誤りです。
【実務直結】最頻値のエクセル計算方法|MODE.SNGL関数とMODE.MULTの使い分け
ビジネス実務において、膨大な行数から最頻値を手計算で探すことは現実的ではありません。Microsoft Excelを使用すれば、関数を用いることで瞬時に割り出すことが可能です。
かつてExcelには「MODE関数」が用意されていましたが、現在のOffice 2010以降では機能が細分化され、公式にも非推奨の互換性関数となっています。実務における最頻値のエクセル計算方法では、用途に応じて以下の2つの最新関数を使い分けるのがベストプラクティスです。
単一の最頻値を求める:MODE.SNGL関数
データ群から最も標準的な1つの最頻値を抽出したい場合は、MODE.SNGL関数を使用します(「SNGL」はSingleの略)。
書式:=MODE.SNGL(範囲)
例:セルA1からA100までの範囲から算出する場合は「=MODE.SNGL(A1:A100)」と入力します。
※注意点として、もしデータ内に最頻値が複数(例:2と5が同数最多)存在した場合、MODE.SNGL関数は「データの上から順に見て先に現れた方の数値」のみを返します。複数の候補があるリスクを考慮する場合は、次に解説する配列関数を検討する必要があります。
複数の最頻値をすべて網羅する:MODE.MULT関数
最頻値が複数存在する可能性を想定し、漏れなくすべてセルに出力したい場合は「MODE.MULT関数」(MULTはMultipleの略)を採用します。
書式:=MODE.MULT(範囲)
最新のMicrosoft 365やExcel 2021以降(スピル機能対応環境)であれば、1つのセルに「=MODE.MULT(A1:A100)」と入力してEnterを押すだけで、該当する最頻値が縦方向のセルへ自動的に展開(スピル)されて表示されます。
なお、該当するデータ内に重複が1つもなく最頻値が存在しない場合、Excelはエラー値「#N/A」を返します。このエラー表示は関数の不具合ではなく、「最頻値が存在しない」という統計的事実を正確に表しています。
【実態検証】ビジネス現場と教育現場で起きている「代表値の誤解」と失敗事例
大手マーケティングリサーチ会社でデータ分析を担当するシニアアナリストや、教育現場の教員への取材・ヒアリングを通じて浮かび上がってきたのは、多くの現場で「代表値の取り違えによる判断ミス」が日常化している実態です。
典型的な失敗事例が、ECサイトにおける「顧客の平均購入単価」に基づいたキャンペーン設計です。あるアパレル通販企業では、平均購入額が「12,800円」だったことから、「12,000円以上の購入で送料無料」という施策を打ち出しました。しかし、蓋を開けてみると売上はほとんど伸びませんでした。
データを再集計したところ、一部の高額アウターまとめ買い顧客(数十万円の購入)が平均値を引き上げていただけでした。実態として顧客が最も多く購入していた最頻値は「4,900円のTシャツ」であり、中央値も「5,800円」付近に集中していたのです。顧客のボリュームゾーンからかけ離れたハードルを設定してしまったことが施策失敗の主因でした。
認知心理学における「アンカリング効果」や「代表性ヒューリスティック」が示す通り、人間は提示された単一の要約数値(特に平均値)を全体の典型的な姿だと思い込んでしまう強いバイアスを持っています。「平均値」「中央値」「最頻値」の3つを必ずセットで並べ、分布の歪みを確認する習慣を持たなければ、現場の真のニーズを捉え損ねることになります。
【プロの結論】おすすめできる人・慎重になるべき人の判断基準
データ分析において、最頻値の活用が真価を発揮するケースと、逆に慎重に扱うべきケースの境界線は明瞭です。
最頻値の活用を推奨するケース:
・アパレルや飲食店の「最も売れるサイズ・メニュー」を特定し、在庫切れを防ぎたい小売・仕入れ担当者
・アンケートの5段階評価(満足・普通・不満など)から、最も多い民意の集約を行いたいリサーチ担当者
・外れ値(異常値)のノイズを完全に遮断し、顧客の最も厚いボリュームゾーンを掴みたいマーケター
最頻値の利用に慎重であるべきケース:
・全体のサンプルサイズ(データ数)が数十件未満と極めて少ない場合(偶然の同一値が最頻値になってしまうリスクが高い)
・連続的な小数点データ(例:精密機械の重量測定値など、全く同一の数値がめったに重複しないデータ群)
・全体の総予算や資材の総消費量を計算したい場合(合計値を把握するには平均値とサンプル数の掛け合わせが不可欠)
【最頻値の求め方】に関するよくある質問(FAQ)
Q1:最頻値が複数ある場合、平均して1つの値にしてはいけませんか?
A1:絶対に平均してはいけません。最頻値は「最も多く現れた実在の数値」を記録する指標です。例えば最頻値が「20歳」と「60歳」の2峰性分布を示している場合、平均して「40歳」としてしまうと、実際には40歳の利用者がほとんどいないにもかかわらず「40歳が典型的である」という完全な虚偽の分析になってしまいます。複数ある場合は「20歳、60歳」と両方をそのまま併記してください。
Q2:中学数学の定期テストで度数分布表が出たとき、「〇〇以上〜〇〇未満」と書いても丸をもらえますか?
A2:原則として減点、または不正解となります。文部科学省の指導指針において、度数分布表における最頻値は「最頻値が含まれる階級の『階級値(中央の値)』」を答えることが厳密に定められています。必ず「(階級の下限+上限)÷2」を計算した数値を単一で解答してください。
Q3:データがすべてバラバラで被りがない場合、ExcelのMODE.SNGL関数はどうなりますか?
A3:重複する数値が1つも存在しない場合、Excelは「#N/A」(ノー・アベイラブル:該当値なし)というエラーを返します。これは数式のミスではなく、「このデータ群には統計学上の最頻値が存在しない」という正しい算出結果です。実務の報告資料等でエラー表示を避けたい場合は、IFERROR関数を組み合わせて「=IFERROR(MODE.SNGL(A1:A10), "なし")」のように記述するとスマートです。
まとめ:データの本質を見抜くために最頻値を武器にする
最頻値は、統計学や数学の中で最も直感的に理解しやすい概念でありながら、ビジネスの意思決定や現状把握において極めて強力な武器となります。平均値という単一の物差しだけに依存していると、極端な外れ値によって現実の姿を見失い、重大な判断ミスを引き起こしかねません。
生データからのカウント、度数分布表における階級値の算出、複数該当時の並記ルール、そしてExcel関数の適切な選定。これら一連の作法を正しく理解し、中央値や平均値と巧みに組み合わせることで、データの背後に隠された「真のボリュームゾーン」を正確に見抜くことができるようになります。数字の表面的な美しさに惑わされず、背後にあるリアリティを掴む第一歩として、最頻値の算出技術を役立ててください。